Contexto: La Ruptura con las Soluciones Privativas
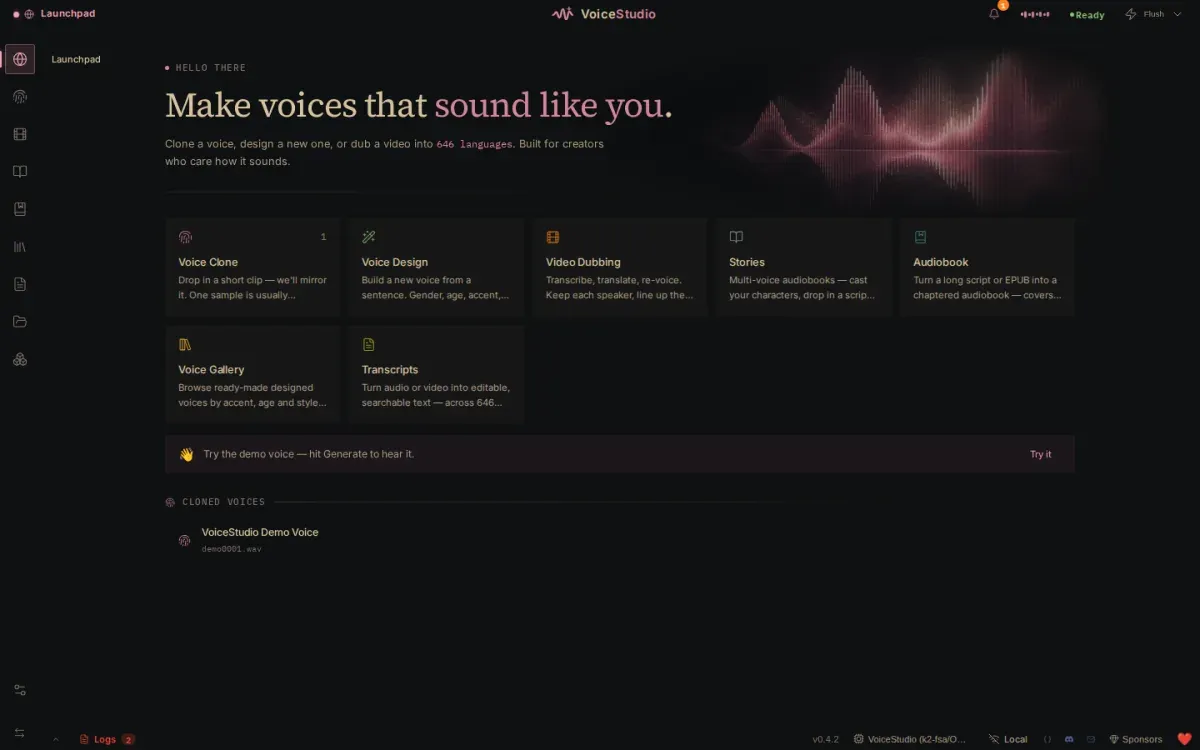
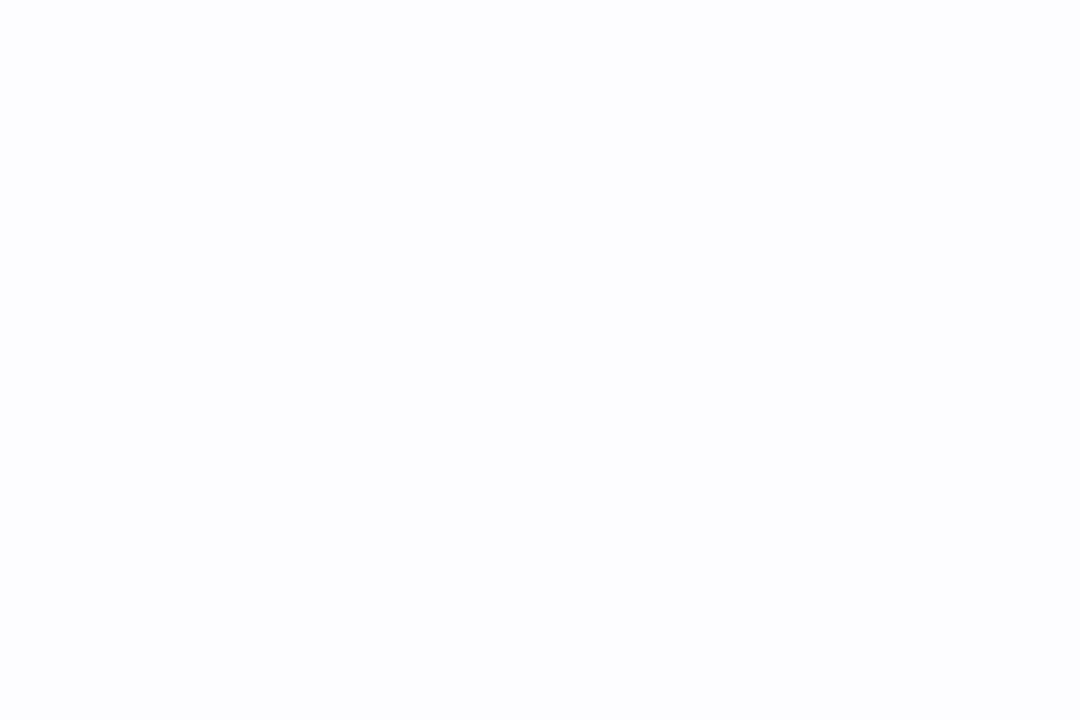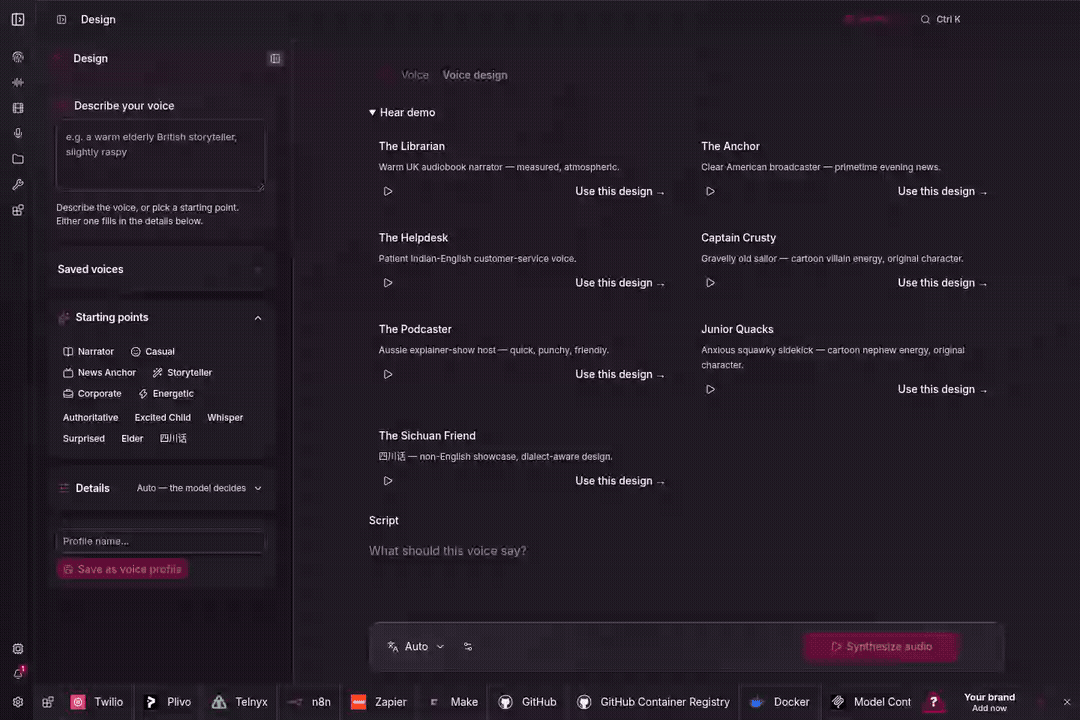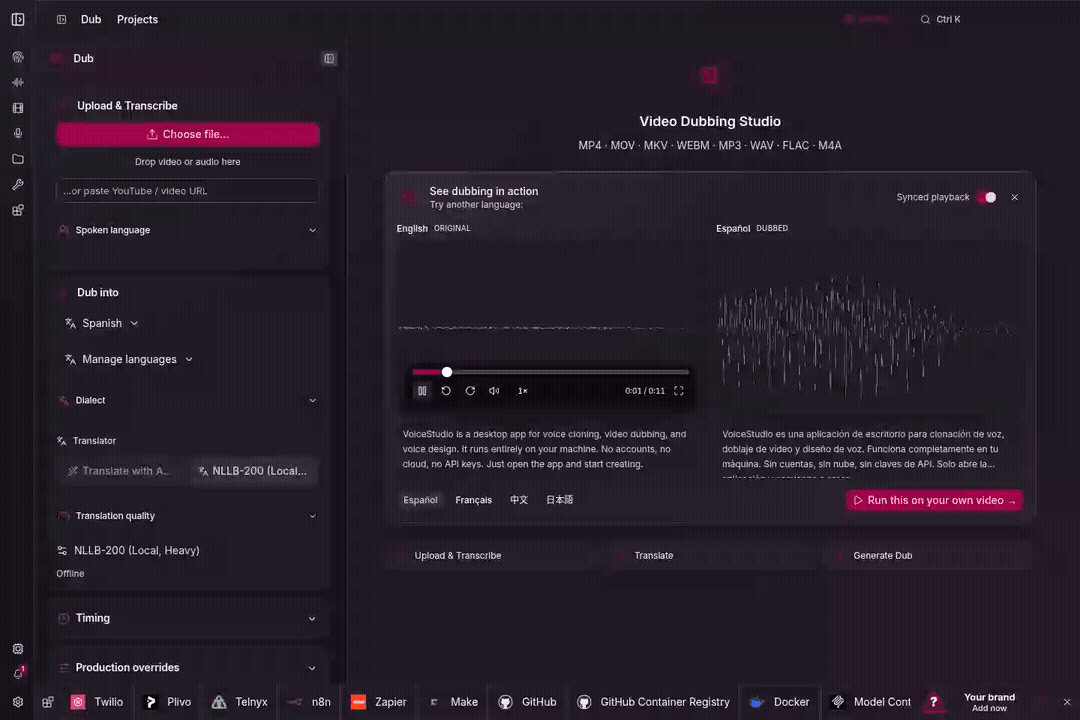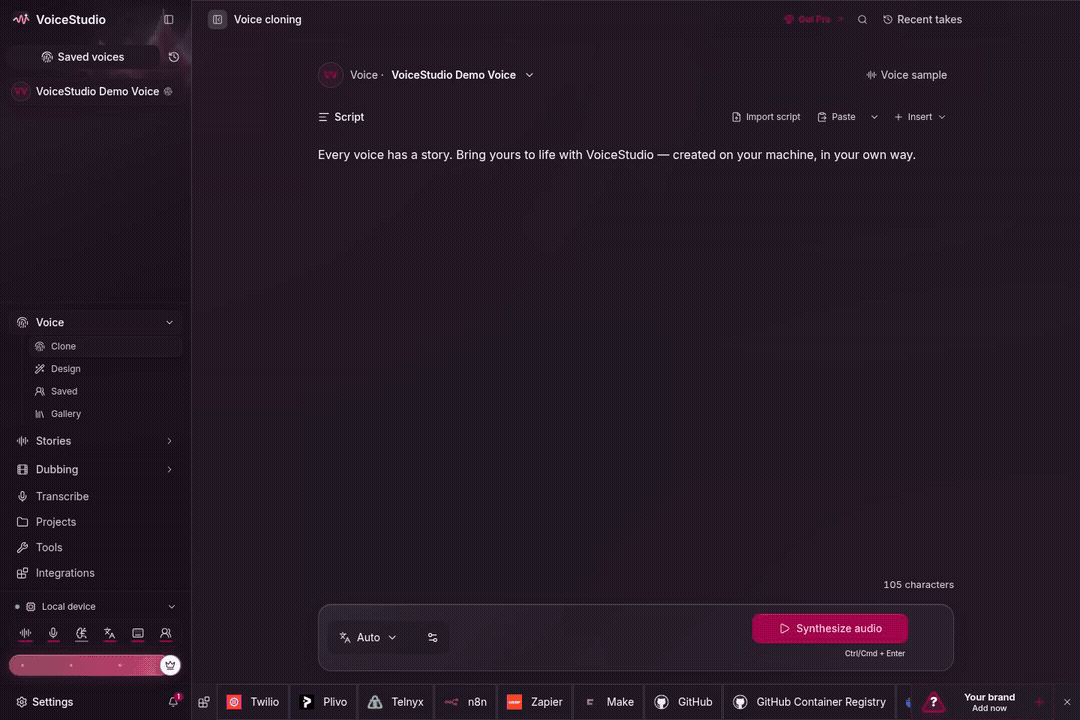 Demostración integral de la interfaz de VoiceStudio: desde la clonación de voz hasta el doblaje de video profesional en un entorno 100% local.
En la última década, la síntesis de voz y la clonación generativa han pasado de ser experimentos académicos a herramientas fundamentales en la economía de la atención. Sin embargo, este progreso ha venido acompañado de una dependencia crítica hacia proveedores de "Caja Negra" como ElevenLabs o OpenAI. Para el desarrollador moderno y el arquitecto de soluciones, esta dependencia representa un riesgo sistémico: precios abusivos por suscripción, latencia impredecible por congestión de red y, lo más preocupante, la entrega de datos biométricos de voz a servidores de terceros donde la privacidad es, en el mejor de los casos, una promesa contractual.
VoiceStudio surge no solo como un proyecto de software, sino como un manifiesto técnico liderado por Palash Deb. Su propósito es claro: proporcionar una alternativa de código abierto, totalmente local y de alto rendimiento que iguale o supere las capacidades de las plataformas SaaS más robustas. La industria ha llegado a un punto de inflexión donde la potencia de cómputo en el borde (Edge Computing) y las optimizaciones en modelos de lenguaje de audio permiten que una estación de trabajo convencional realice tareas que hace dos años requerían clústeres de GPUs en la nube.
La filosofía de VoiceStudio se asienta sobre la soberanía del dato. Al ejecutar modelos como OmniVoice (de k2-fsa) directamente en el hardware del usuario, se elimina la fuga de metadatos y se garantiza la continuidad del negocio sin depender de una conexión a Internet o de la estabilidad financiera de una startup en Silicon Valley. Este proyecto ha capturado la atención de la comunidad global (con más de 63,000 estrellas en GitHub) porque resuelve el dilema ético y técnico de la IA: ¿cómo podemos innovar sin ceder el control de nuestra identidad vocal?
El impacto de VoiceStudio es disruptivo. Al soportar 646 idiomas, rompe las barreras lingüísticas que los servicios comerciales suelen ignorar por falta de rentabilidad inmediata. No es solo una herramienta para clonar voces; es una plataforma de infraestructura para la nueva era de la comunicación sintética, permitiendo desde la creación de audiolibros masivos hasta la integración de agentes de IA con latencia cero a través de protocolos locales.
Arquitectura del Sistema y Motor de Inferencia
La arquitectura de VoiceStudio es un ejercicio de ingeniería de software moderna que prioriza el desacoplamiento y la eficiencia. A diferencia de las herramientas monolíticas, VoiceStudio utiliza un modelo de Runtime Gestionado que separa la capa de presentación de la lógica de inferencia pesada.
El Frontend: Una Experiencia Desktop Nativa
VoiceStudio ha migrado recientemente de Tauri a Electron, una decisión estratégica para mejorar la compatibilidad con el ecosistema de Node.js y facilitar la gestión de dependencias complejas de Python. La interfaz no es un simple envoltorio web; es un espacio de trabajo multimodular que gestiona proyectos, modelos y colas de renderizado. Utiliza Bun como motor de ejecución de JavaScript, lo que acelera drásticamente el tiempo de arranque y la respuesta de la UI en comparación con Node tradicional.
El Corazón del Sistema: El Backend Python y los Motores de Inferencia
El verdadero músculo reside en el backend de Python, que actúa como un servidor de inferencia de alto rendimiento. VoiceStudio no está atado a un solo modelo. Aunque su motor predeterminado es k2-fsa/OmniVoice, su arquitectura es extensible (pluggable). Esto permite al sistema alternar entre diferentes arquitecturas de redes neuronales según la tarea:
- Clonación de voz: Utiliza técnicas de few-shot learning donde unos pocos segundos de audio de referencia permiten generar un modelo latente de la voz objetivo.
- Diseño de voz: Implementa modelos condicionados por texto, donde descriptores semánticos ("voz profunda", "tono calmado") se traducen en parámetros de síntesis.
- Doblaje: Integra algoritmos de alineación temporal para asegurar que el audio generado coincida con los timestamps del video original.
Gestión de Memoria y Aceleración de Hardware
Uno de los mayores desafíos de la IA local es la gestión de la VRAM. VoiceStudio implementa un sistema de carga dinámica de modelos. Los pesos de los modelos (que pueden ocupar varios gigabytes) solo se cargan en la memoria de la GPU cuando es estrictamente necesario y se mantienen en caché de forma inteligente. El soporte para NVIDIA CUDA es nativo, pero la optimización para Apple Silicon (MPS) es donde el proyecto brilla, permitiendo a los usuarios de Mac Studio y MacBook Pro realizar inferencias casi en tiempo real, algo impensable hace poco tiempo en hardware de consumo.
Características Disruptivas y Matriz de Capacidades
VoiceStudio se diferencia de sus competidores por un conjunto de funcionalidades que van más allá de la simple conversión de texto a voz (TTS). Su enfoque es la producción integral de contenido.
| Característica Clave | VoiceStudio (Local) | ElevenLabs (SaaS) | Coqui TTS (Legacy OS) |
|---|---|---|---|
| Privacidad y Soberanía | 100% Local y Seguro | Datos en Nube / Telemetría | Local, pero complejo |
| Modelo de Costes | Gratuito y Libre | Suscripciones / Créditos | Gratuito |
| Latencia y Modo Offline | Ejecución sin Red | Requiere Conexión | Inferencia Lenta |
| Flexibilidad de Modelos | Soporta múltiples motores | Modelo Cerrado | Limitado a modelos base |
| Escalabilidad Programática | API Local y MCP | Cuotas y Rate Limits | Sin Servidor Headless |
| Alcance Lingüístico | 646 Idiomas | ~30 Idiomas principales | Limitado por modelo |
Innovaciones Técnicas Destacadas:
- Diseño de Voz mediante Prompting: A diferencia de la clonación, donde necesitas una fuente, el diseño de voz permite crear identidades vocales inexistentes simplemente describiéndolas. Esto es vital para creadores que buscan una "marca sonora" única sin usar voces de stock.
- Doblaje Automático con Preservación de Tiempo: El sistema analiza el flujo de audio de un video, transcribe, traduce y genera la nueva voz manteniendo la sincronización. Es una solución end-to-end que reduce semanas de trabajo de postproducción a minutos.
- Widget de Dictado Flotante: Una utilidad de sistema que permite dictar texto en cualquier aplicación utilizando los modelos locales de alta precisión, superando con creces a los dictados nativos de Windows o macOS.
- Integración con MCP (Model Context Protocol): VoiceStudio puede actuar como un "skill" para agentes de IA (como Claude o GPT locales), permitiendo que los agentes "hablen" con voces personalizadas a través de una interfaz estandarizada.
[!WARNING]
callout warn Requisitos Críticos de Hardware
Para una experiencia fluida de inferencia, se recomienda:
- GPU: Mínimo 8GB de VRAM (NVIDIA RTX 3060 o superior) para modelos de alta fidelidad.
- Apple Silicon: Chips M1/M2/M3 con al menos 16GB de memoria unificada.
- Almacenamiento: 15GB a 50GB de espacio libre para la descarga de diversos modelos y pesos neuronales.
- RAM: 16GB mínimo (32GB recomendados para multitarea intensiva).
Casos de Uso del Mundo Real y Aplicaciones Prácticas
La versatilidad de VoiceStudio permite su despliegue en sectores que anteriormente estaban limitados por los costes de las APIs de nube.
1. Producción de Contenido Multimedia y Localización
Para los creadores de contenido en YouTube, plataformas de e-learning o cine independiente, el doblaje ha sido históricamente el mayor gasto. Con VoiceStudio, una productora puede clonar la voz de un narrador original y generar versiones en 20 idiomas diferentes manteniendo la misma identidad vocal. Esto no solo ahorra dinero, sino que garantiza una experiencia de usuario consistente a nivel global. El flujo de trabajo implica cargar el video, seleccionar los idiomas de destino y dejar que el motor de inferencia procese el doblaje con alineación temporal automática.
2. Agentes Autónomos y Asistentes de Voz Locales
En el ámbito de la domótica y la asistencia personal, la privacidad es sagrada. VoiceStudio permite integrar voces hiperrealistas en asistentes como Home Assistant o espejos inteligentes. Al utilizar la API Local, un desarrollador puede enviar texto desde un LLM (como Llama 3) y recibir el audio de forma instantánea. La integración con MCP permite que herramientas como "Claude Desktop" utilicen VoiceStudio para comunicarse verbalmente con el usuario sin que el audio pase por los servidores de Anthropic.
3. Accesibilidad y Preservación de la Identidad Vocal
Este es quizás el caso de uso más humano. Personas con enfermedades degenerativas (como la ELA) pueden usar VoiceStudio para clonar su propia voz mientras aún pueden hablar. A diferencia de las soluciones en la nube que podrían desaparecer o cambiar sus términos, VoiceStudio les permite poseer su "identidad digital" para siempre, utilizándola en dispositivos de comunicación asistida de forma offline y privada. Además, la capacidad de manejar 646 idiomas permite a comunidades lingüísticas minoritarias crear sus propias herramientas de accesibilidad.
4. Videojuegos y Narrativa Interactiva Dinámica
Los desarrolladores de juegos pueden utilizar VoiceStudio para generar diálogos de NPCs (personajes no jugadores) en tiempo real. En lugar de grabar miles de líneas de voz predeterminadas, el juego puede generar audio basado en el contexto de la partida. Gracias a la aceleración por hardware y la baja latencia, las conversaciones pueden ser verdaderamente dinámicas, permitiendo que cada jugador tenga una experiencia auditiva única sin aumentar el tamaño del instalador del juego, ya que los modelos se ejecutan en el cliente.
Guía Técnica de Despliegue y Comandos de Instalación
VoiceStudio ofrece un instalador simplificado que gestiona la compleja configuración del entorno de Python y las bibliotecas de audio.
- Fase 1Preparación del EntornoVerificación de drivers GPU (CUDA) y herramientas de compilación
- Fase 2Instalación del RuntimeEjecución del script de instalación que configura Python y Node/Bun
- Fase 3Sincronización de CódigoDescarga de la última versión estable del frontend Electron
- Fase 4Gestión de ModelosDescarga inicial de pesos para el motor OmniVoice (aprox. 2GB)
- Fase 5Validación de ServicioLevantamiento de la API local y primer test de generación (WAV)
Comandos para Sistemas Unix (macOS / Linux)
Para instalar la versión más reciente de la aplicación Electron:
curl -fsSL https://voicestudio.sh/install | shComandos para Windows (PowerShell)
Ejecutar con privilegios de administrador para asegurar la correcta configuración de las variables de entorno:
irm https://voicestudio.sh/install | iexPrueba de Inferencia vía API (Python)
Una vez que el servicio está corriendo, puedes interactuar con él programáticamente:
import requestsurl = "http://localhost:8080/v1/audio/speech"payload = { "model": "voicestudio-omni", "input": "Hola, esto es una prueba de síntesis de voz totalmente local y privada.", "voice": "cloned_voice_01"}response = requests.post(url, json=payload)with open("salida.mp3", "wb") as f: f.write(response.content)print("Audio generado con éxito.")Opciones de Despliegue y Toma de Decisiones
El arquitecto de sistemas debe elegir el método de despliegue que mejor se adapte a sus necesidades de escalabilidad y aislamiento.
Análisis de Opciones:
- Nativo Local: Es la opción recomendada para usuarios finales y creadores. Ofrece el mejor rendimiento al acceder directamente a los recursos de la GPU sin capas de virtualización. Sin embargo, requiere que el sistema tenga las versiones correctas de los drivers de NVIDIA o el framework Metal.
- Docker: Ideal para desarrolladores que no quieren "ensuciar" su sistema operativo con múltiples versiones de Python y librerías de procesamiento de señales. El contenedor de VoiceStudio viene preconfigurado con todas las dependencias, aunque requiere configurar el passthrough de la GPU (NVIDIA Container Toolkit).
- Modo API Headless: Para empresas que desean montar su propio "ElevenLabs Privado" en un servidor interno. Se desactiva la interfaz de Electron y se utiliza únicamente el backend de Python, permitiendo que múltiples aplicaciones en la red local consuman el servicio de síntesis de voz.
Licenciamiento, Ecosistema y Fuentes Oficiales
VoiceStudio está bajo la licencia GNU Affero General Public License v3.0 (AGPL-3.0). Esta es una elección deliberada y valiente. Al ser AGPL, cualquier persona que modifique el software y lo ofrezca como un servicio a través de una red debe liberar sus cambios bajo la misma licencia. Esto protege al proyecto de ser "secuestrado" por empresas que busquen crear versiones privativas basadas en el trabajo de la comunidad.
Es importante destacar que, si bien el código de la aplicación es libre, los pesos de los modelos y las voces clonadas pueden tener sus propias licencias y restricciones éticas. El "Model Manager" integrado en VoiceStudio incluye ahora avisos sobre la fuente de los modelos y enlaces de evidencia para asegurar que el usuario esté informado sobre la procedencia de la tecnología que está utilizando.
El futuro de VoiceStudio apunta hacia una integración aún más profunda con el ecosistema de IA generativa, incluyendo soporte para modelos de "Speech-to-Speech" (traducción de voz directa sin pasar por texto) y una optimización continua para hardware de bajo consumo.
Fuentes y Referencias
- Repositorio oficial en GitHub: debpalash/VoiceStudio
- Sitio Web oficial: voicestudio.sh
- Licencia oficial del proyecto: AGPL-3.0 License
- Documentación técnica de motores: VoiceStudio Engine Guides
- Comunidad y soporte: Discord Oficial de VoiceStudio
chat Comentarios (0)
Escribir un comentario
Identificación con Google requerida
Inicia sesión con tu cuenta de Gmail para verificar tu identidad y mostrar tu foto de perfil real al comentar.
Sé el primero en comentar esta publicación.